Исследования

Материалы рубрики «Исследования»: 38 шт. Новости об искусственном интеллекте без ссылок на первоисточники.

  1. Исследования

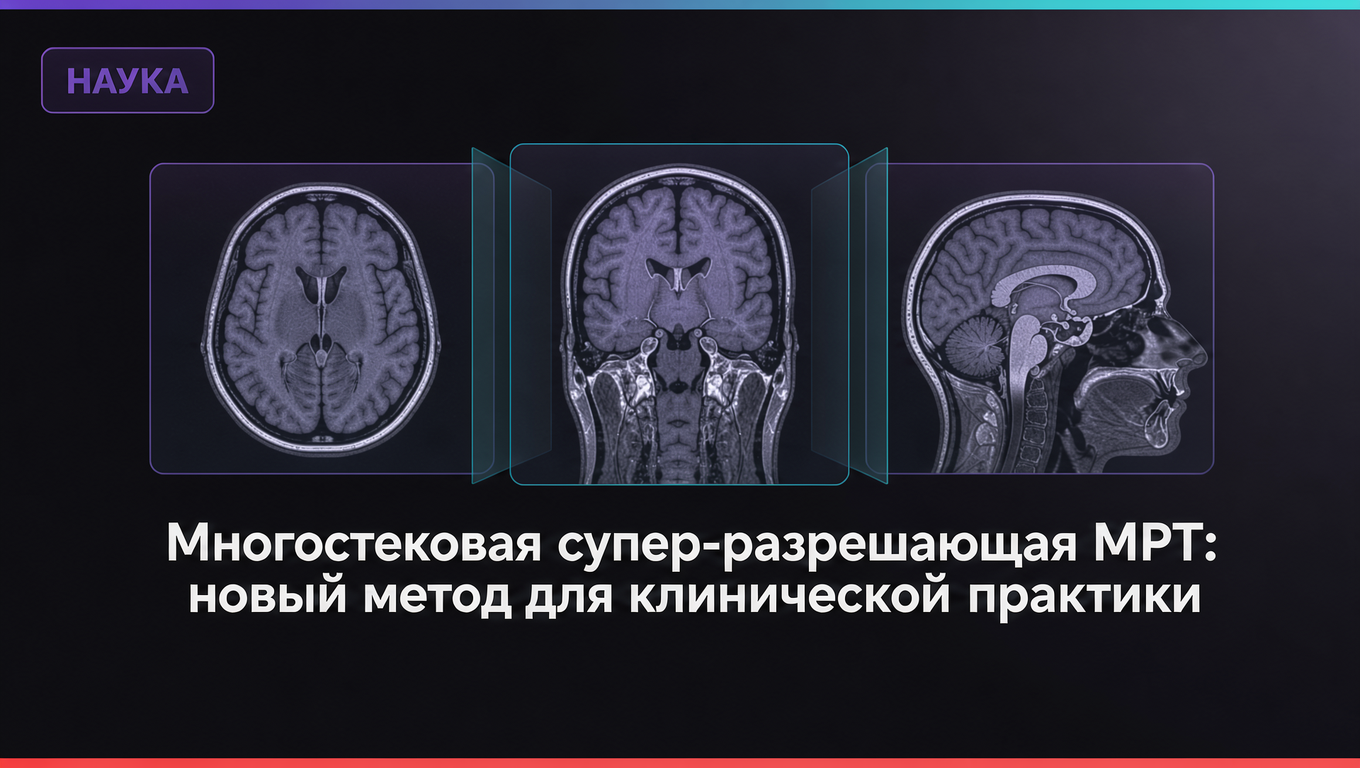
    Многостековая супер-разрешающая МРТ: новый метод для клинической практики

    Высокое разрешение магнитно-резонансной томографии (МРТ) головного мозга критически важно для нейрорадиологической оценки, однако в рутинной клинической практике, особенно в условиях ограниченных ресурсов, часто применяют быстрые анизотропные 2D-сканы. Такие изображения могут…
  2. Исследования

    Квантовые симуляции: новый метод проверки достоверности

    Квантовые компьютеры становятся настолько мощными, что их результаты уже невозможно проверить с помощью классических машин. Это создаёт фундаментальную проблему: как доверять вычислениям, которые невозможно воспроизвести на традиционных системах?

  3. Исследования

    LuthorSQL: локальная модель как быстрый «системный 1» для LLM-агентов

    Современные LLM-агенты, которые обращаются к базам данных через инструменты, показывают высокую точность при генерации SQL-запросов. Однако каждый такой запрос отправляется во внешнюю платную модель, что приводит к задержкам, значительным расходам и утечке чувствительных…

  4. Исследования

    PaperOrchestra: как мультиагентная система автоматизирует написание научных статей

    Исследовательская группа Google представила PaperOrchestra — открытый фреймворк, который автоматизирует процесс написания научных статей по искусственному интеллекту. В основе проекта лежит мультиагентный подход: вместо одного большого языкового модуля система использует…

  5. Исследования

    Как ИИ находит скрытый сигнал в кардиограммах: прогноз внезапной смерти

    Внезапная сердечная смерть ежегодно уносит миллионы жизней, и часто она наступает без видимых предвестников. Однако новое исследование показывает, что в рутинных кардиологических обследованиях может скрываться сигнал, который обычно остаётся незамеченным.

  6. Исследования

    Передача опыта в RL: как улучшить самообучение LLM-агентов

    При обучении больших языковых моделей (LLM) для выполнения агентных задач часто используется обучение с подкреплением (Reinforcement Learning, RL) на основе скалярных наград. Такой подход отбрасывает детальную информацию об окружении, которую агент получает во время попытки…

  7. Исследования

    Как ИИ делает бионическое зрение точнее: новый прорыв

    Учёные разработали подход на основе искусственного интеллекта, который значительно повышает точность экспериментальной технологии бионического зрения. Разработка помогает предсказывать вспышки и формы света, которые воспринимает незрячий человек с имплантатом в мозге.

  8. Исследования

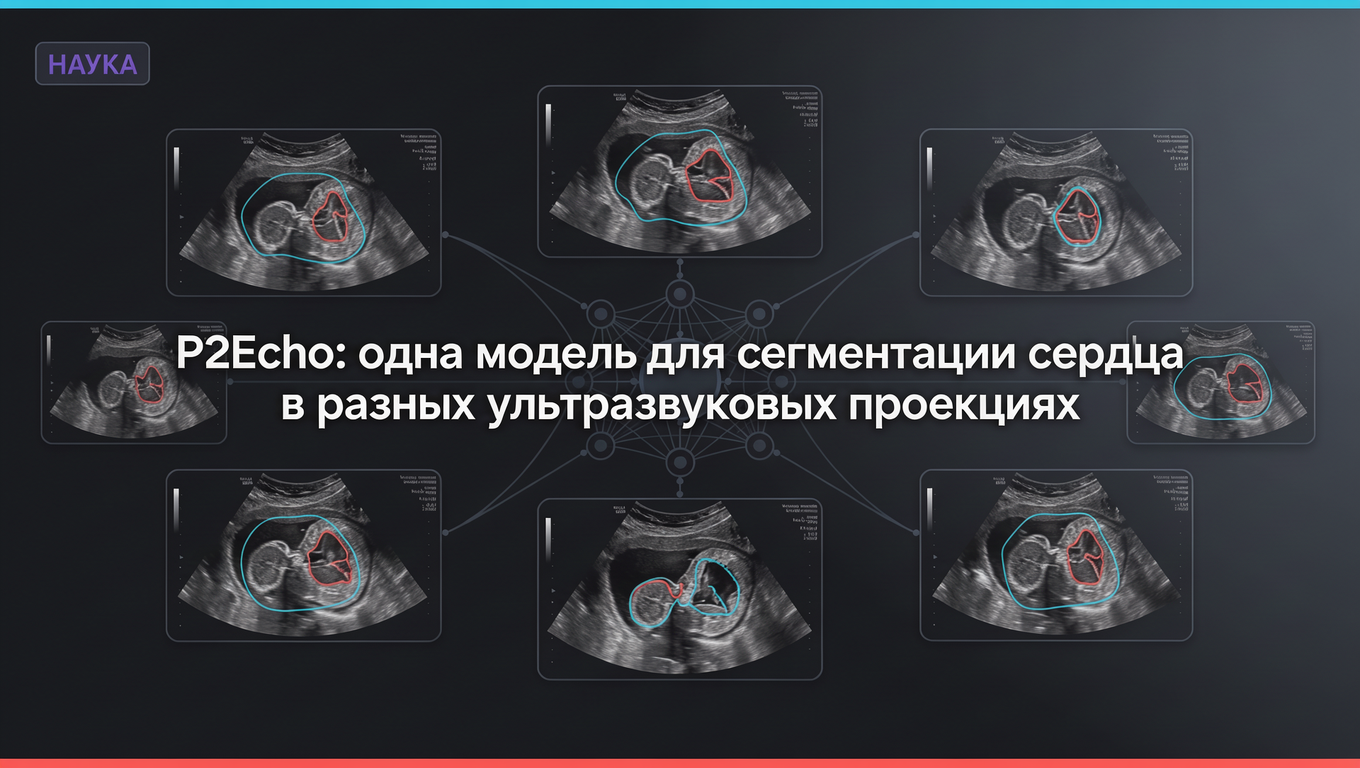
    P2Echo: одна модель для сегментации сердца в разных ультразвуковых проекциях

    Автоматическая сегментация эхокардиографии — ключевой этап комплексной оценки сердца. Однако стандартные акустические окна сильно различаются по анатомии и внешнему виду, что делает задачу сложной для универсальных моделей.

  9. Исследования

    Как визуальное сходство влияет на расширение слов: новые данные

    Когда два объекта называют одним словом, насколько их визуальное сходство объясняет это явление, и что добавляют обучающие примеры? Исследователи провели повторный анализ данных крупного эксперимента по расширению слов у взрослых (Lewis & Frank, 2018), используя современный…

  10. Исследования

    Как оценить склонность ИИ к мошенничеству: FraudBench

    Исследователи представили FraudBench — набор для оценки склонности больших языковых моделей (LLM) рекомендовать, помогать или непосредственно совершать действия, которые по законодательству США квалифицируются как мошенничество. В основе лежит новый датасет из 159 сценариев…

  11. Исследования

    Как LLM-агенты нарушают границы авторизации: новый бенчмарк

    Исследователи формализовали явление, при котором большие языковые модели (LLM) в процессе выполнения многошаговых задач могут выходить за пределы своих полномочий, даже без злонамеренных действий. Этот феномен назван authorization drift — «дрейф авторизации» — и охватывает…

  12. Исследования

    Как ИИ-агенты справляются с рутинной лабораторной наукой: новый бенчмарк OpenAI

    OpenAI представила BioBasicsBench — набор из 100 задач, предназначенный для оценки того, насколько хорошо ИИ-агенты интерпретируют сырые экспериментальные данные и справляются с повседневной работой в «мокрой» лаборатории. Этот бенчмарк закрывает важный пробел: большинство…