Исследования

Материалы рубрики «Исследования»: 38 шт. Новости об искусственном интеллекте без ссылок на первоисточники.

  1. Исследования

    Линейное внимание и стирание: почему стирание менее важно, чем запись

    Линейное внимание — это метод, который сжимает контекст в состояние фиксированного размера, что позволяет обучать модель за линейное время и использовать постоянный объем памяти при инференсе. В моделях с гейтированным дельта-правилом состояние сначала затухает, а затем стирает…
  2. Исследования

    Почему гонка за токенами в секунду вредит ИИ-сообществу: предложение о краудсорсинговых бенчмарках

    Сообщество разработчиков больших языковых моделей всё чаще зацикливается на одном показателе — скорости генерации токенов в секунду. Этот параметр стал своего рода «гонкой вооружений»: чем выше цифра, тем лучше считается модель.

  3. Исследования

    Почему оплачиваемые опросы для конференций становятся нормой

    Академическое сообщество всё чаще сталкивается с новым форматом сбора данных — оплачиваемыми исследовательскими опросами, предназначенными для подготовки докладов на конференции. Такая практика позволяет авторам получать качественные данные от респондентов, которые мотивированы…

  4. Исследования

    Почему Retell выбирает OpenAI: 100 млн звонков в месяц

    Retell, платформа для создания голосовых агентов, достигла впечатляющего показателя — 100 миллионов обрабатываемых звонков в месяц. Этот результат стал возможен благодаря использованию моделей OpenAI, включая GPT-6 Astra, которая заняла первое место в бенчмарке Retell для…

  5. Исследования

    Как снять ограничение порядка генерации в autoregressive-моделях изображений

    Авторегрессионные (AR) генераторы изображений теоретически мощны, но на практике негибки: обучение с фиксированным растровым порядком токенов закрепляет в модели единственный способ факторизации распределения изображений, лишая её возможности инпейнтинга, аутпейнтинга или…

  6. Исследования

    Google представила Gemini 4 Carbon и вернула лидерство в обновлённых бенчмарках

    Google анонсировала новую модель искусственного интеллекта Gemini 4 Carbon, которая вновь заняла первое место в обновлённых и более сложных тестах. Это первый крупный релиз компании после Gemini 3, и он ориентирован на задачи, требующие высокой производительности и глубокого…

  7. Исследования

    Как магнитные вихри помогут создать компьютеры, работающие как мозг

    Учёные впервые сняли на видео, как крошечные магнитные вихри — скирмионы — плавятся, покидая упорядоченную решётку. Это открытие показывает новые способы управления этими необычными структурами и приближает создание нейроморфных компьютеров, которые имитируют работу…

  8. Исследования

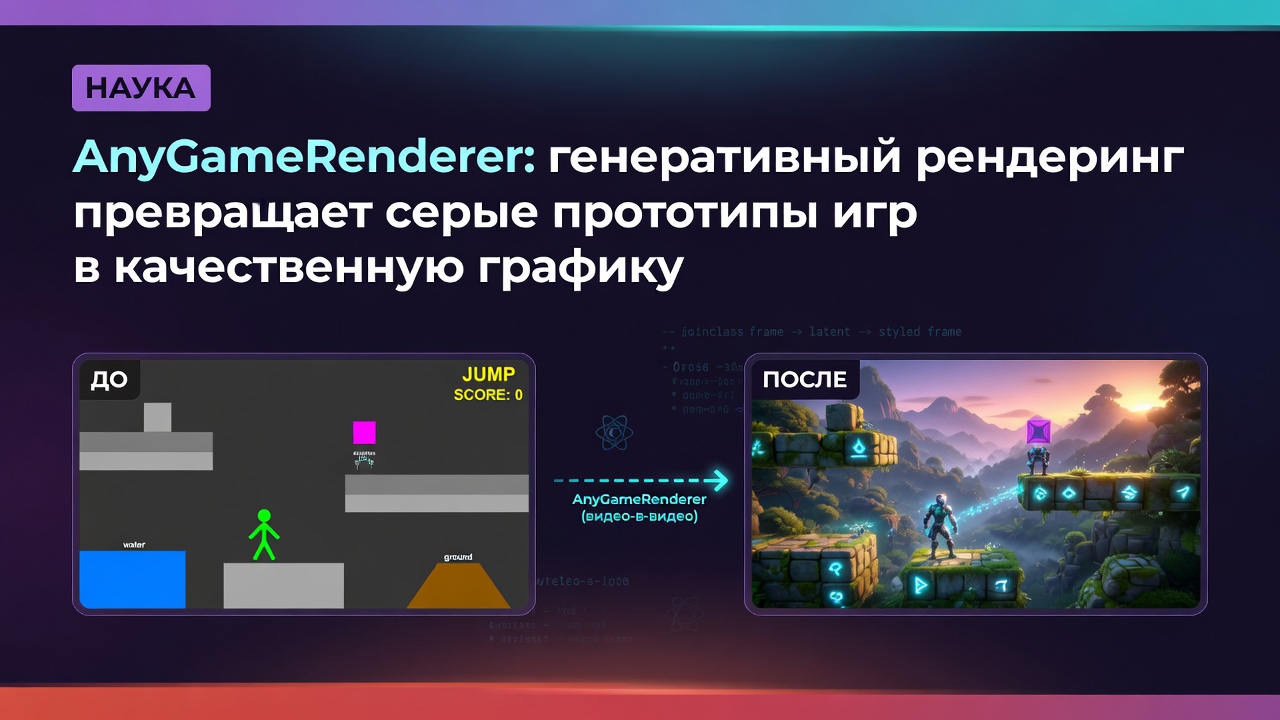
    AnyGameRenderer: генеративный рендеринг превращает серые прототипы игр в качественную графику

    ИИ-агенты для программирования уже умеют собирать небольшие играбельные прототипы за считанные минуты. Однако результат обычно выглядит как «программистский арт»: серые блоки, цветные геометрические примитивы и плоские семантические пятна.

  9. Исследования

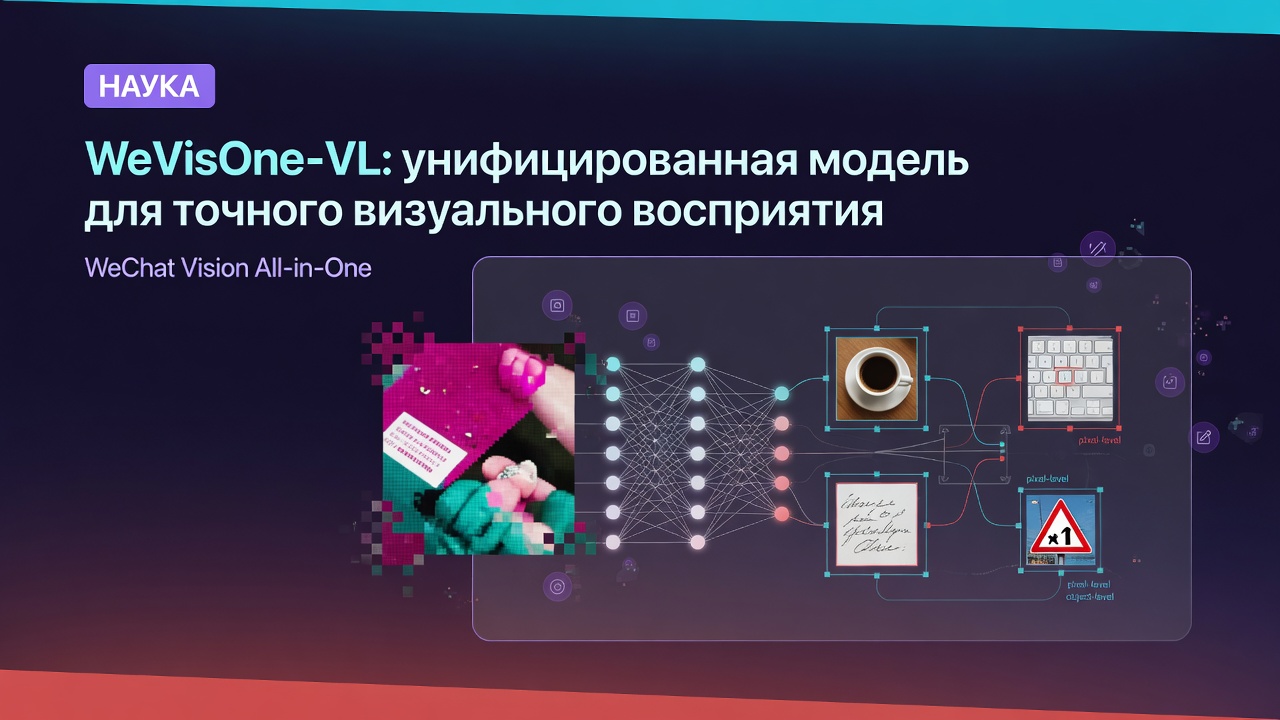
    WeVisOne-VL: унифицированная модель для точного визуального восприятия

    Современные мультимодальные модели, объединяющие обработку текста и изображений, часто справляются с грубыми задачами вроде классификации, но теряют точность, когда требуется детальное понимание визуальной сцены. Новый подход WeVisOne-VL (WeChat Vision All-in-One) предлагает…

  10. Исследования

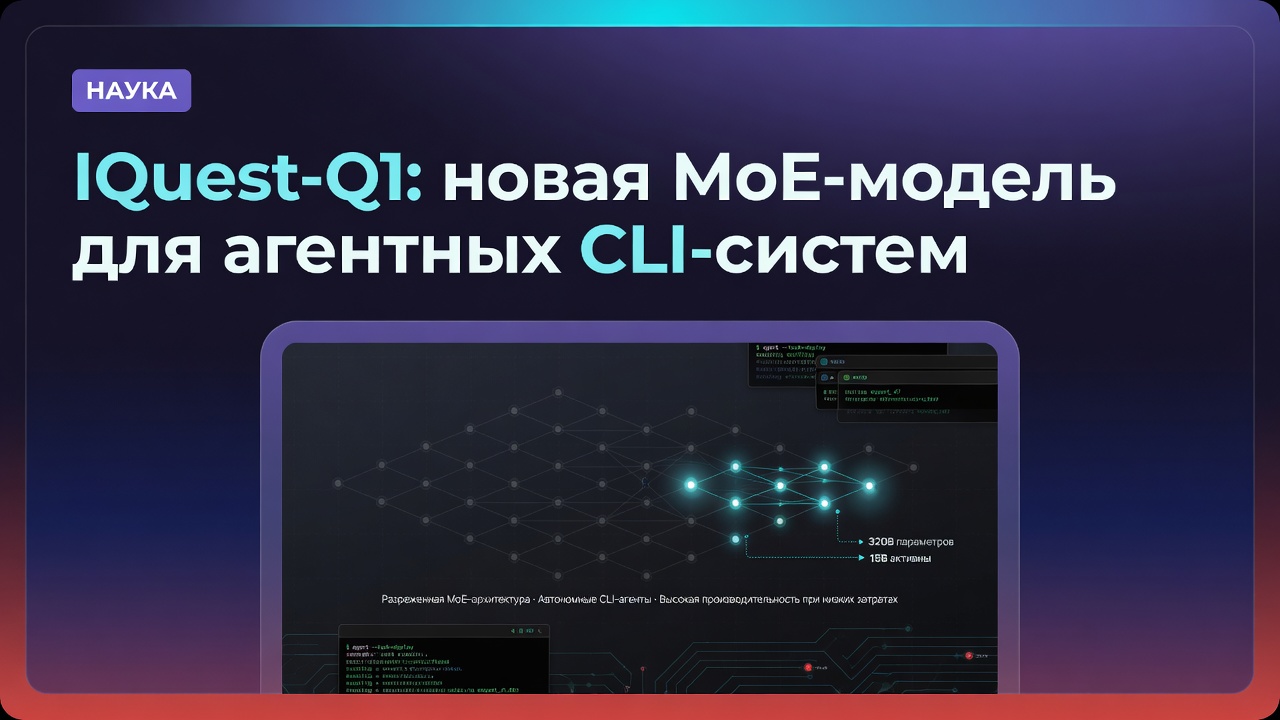
    IQuest-Q1: новая MoE-модель для агентных CLI-систем

    Представлена IQuest-Q1 — разреженная модель на основе смеси экспертов (MoE) с 320 миллиардами параметров, из которых при каждом запросе активируются только 15 миллиардов. Такая архитектура позволяет сочетать высокую производительность с умеренными вычислительными затратами.

  11. Исследования

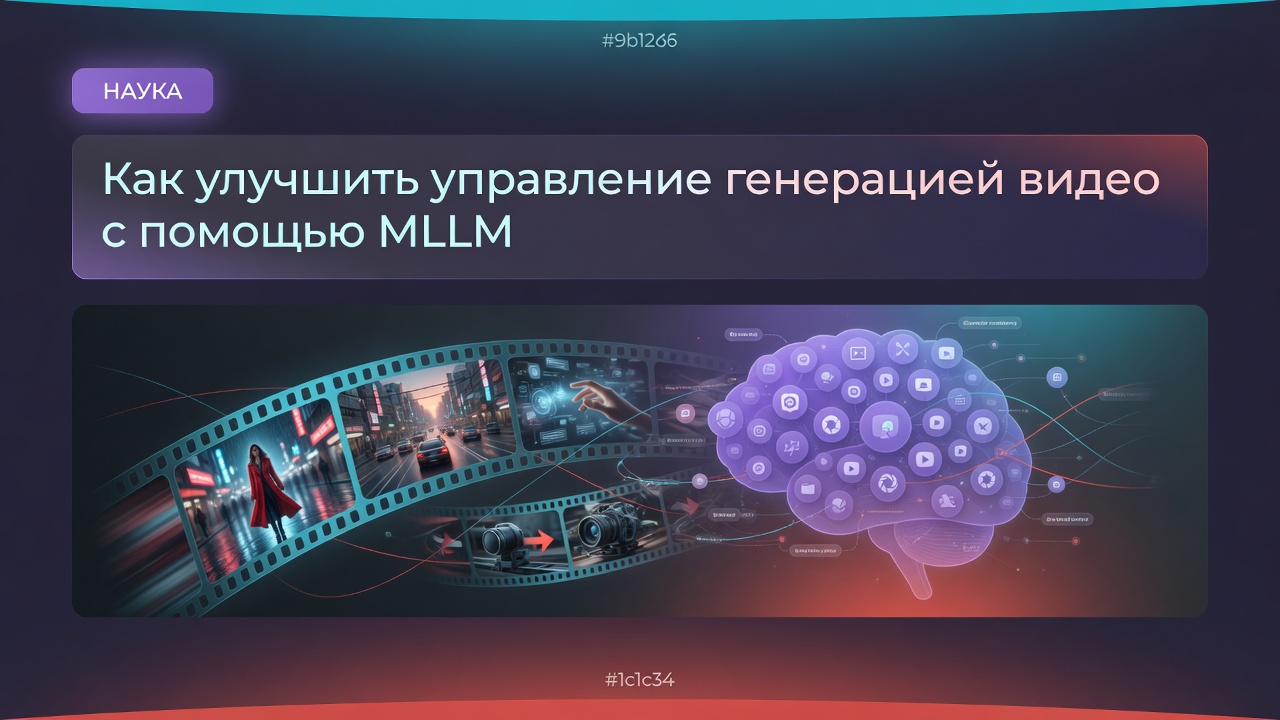
    Как улучшить управление генерацией видео с помощью MLLM

    Создание кинематографичных видео требует не только временной интерполяции от ограниченных входных данных, но и контроля над такими факторами, как персонаж, сцена, действие и камера. Мультимодальные большие языковые модели (MLLM) предоставляют полезные предварительные знания для…

  12. Исследования

    Xiaomi-Lens-0: как модель учится понимать детали изображений

    Современные мультимодальные большие языковые модели (MLLM) неплохо отвечают на вопросы о целых изображениях, но испытывают трудности с пониманием мелких деталей и отдельных областей. Основная причина — текстовое обучение не указывает, какие именно регионы изображения…