
Почему компании переплачивают за текстовые ответы ИИ: подход Jev
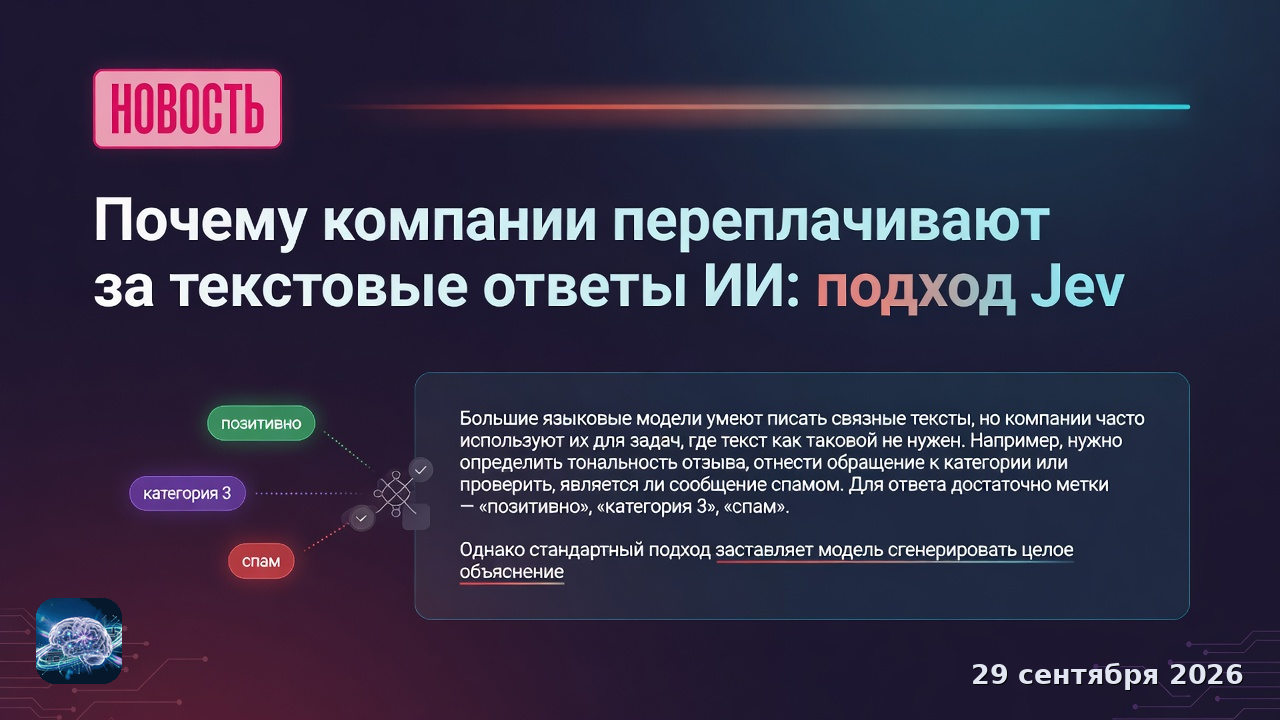
Большие языковые модели (LLM) умеют писать связные тексты, но компании часто используют их для задач, где текст как таковой не нужен. Например, нужно определить тональность отзыва, отнести обращение к категории или проверить, является ли сообщение спамом.
Главное
- Классификация не требует генерации текста — нужна только метка
- Текстовые ответы LLM увеличивают расходы и задержку
- Jev исключает лишнюю генерацию, возвращая метку напрямую
- Подход подходит для задач с категориальным ответом
- Экономия достигается без потери качества классификации
Большие языковые модели (LLM) умеют писать связные тексты, но компании часто используют их для задач, где текст как таковой не нужен. Например, нужно определить тональность отзыва, отнести обращение к категории или проверить, является ли сообщение спамом. Для ответа достаточно метки — «позитивно», «категория 3», «спам». Однако стандартный подход заставляет модель сгенерировать целое объяснение или абзац, чтобы в конце получить один бит информации.
Это избыточно: каждая генерация требует вычислительных ресурсов, времени и токенов. Чем больше текста, тем выше стоимость запроса и тем медленнее система. На масштабе тысяч и миллионов обращений разница становится существенной. Jev предлагает более дешёвый способ: модель сразу возвращает только нужную метку, минуя этап развёрнутого ответа. Такой подход снижает нагрузку и ускоряет обработку, сохраняя точность классификации.
По сути, это возврат к правильной постановке задачи. Если решению нужна только метка, не стоит платить за генерацию текста. Jev показывает, что оптимизация может быть простой: убрать лишнее звено из конвейера. Для бизнеса это означает меньшие расходы на инфраструктуру и более быстрые сервисы.