

Speakrail: локальный голосовой ассистент с низкой задержкой на одной RTX 4090
Speakrail — голосовой ассистент, который работает полностью локально и умещается на одной видеокарте RTX 4090. В отличие от облачных решений, он не отправляет аудио и текст на внешние серверы, поэтому задержка определяется только производительностью оборудования и оптимизацией…
Главное
- Полностью локальная обработка речи без отправки данных в облако
- Одна RTX 4090 обеспечивает работу всего конвейера: распознавание, языковая модель, синтез
- Низкая задержка достигается за счёт связки специализированных моделей
- Автономность полезна для сценариев с чувствительными голосовыми данными
- Архитектура допускает замену отдельных компонентов под конкретные задачи
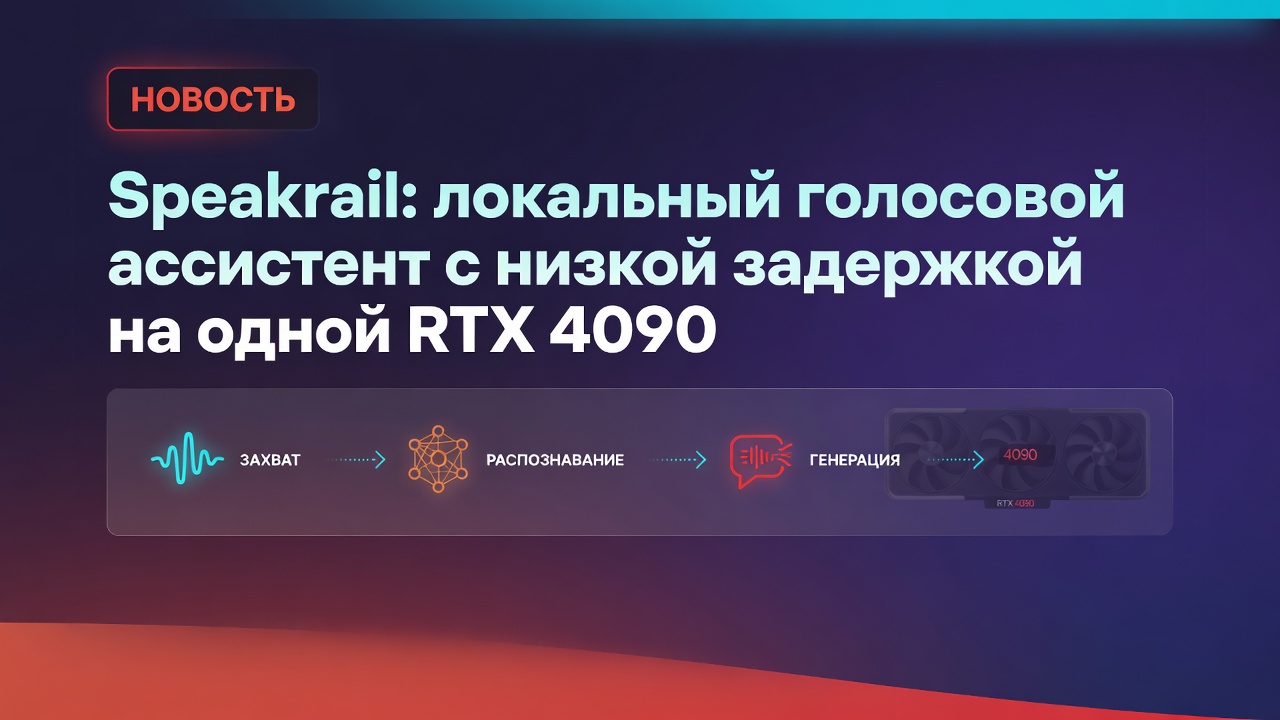
Speakrail — голосовой ассистент, который работает полностью локально и умещается на одной видеокарте RTX 4090. В отличие от облачных решений, он не отправляет аудио и текст на внешние серверы, поэтому задержка определяется только производительностью оборудования и оптимизацией конвейера. Заявленная архитектура рассчитана на обработку речи в реальном времени: захват звука, распознавание, генерация ответа и синтез речи выполняются на одном устройстве.
Ключевая особенность — низкая задержка при полностью локальном выполнении. Обычно локальные модели требуют компромисса между качеством и скоростью, но Speakrail использует связку из специализированных моделей: лёгкая модель распознавания речи, компактная языковая модель для формирования ответа и быстрый синтезатор. Такой подход позволяет сократить время ответа до значений, комфортных для диалога, и при этом сохранить конфиденциальность данных. Для работы достаточно одной RTX 4090, что делает систему доступной для локального развертывания без кластеров и облачных мощностей.
Отдельного внимания заслуживает автономность. Поскольку весь конвейер работает на стороне пользователя, отпадает зависимость от интернет-соединения и внешних API. Это важно для сценариев, где нельзя передавать голосовые данные третьим лицам: корпоративные переговоры, медицинские записи, личные помощники. Кроме того, локальный запуск упрощает доработку системы под конкретные задачи — можно менять отдельные компоненты, не затрагивая остальные.
Speakrail показывает, что качественный голосовой интерфейс больше не требует обязательного подключения к облаку. Оптимизация под одну мощную видеокарту делает такие ассистенты практичными для рабочих станций и домашних серверов. Основной вызов — баланс между размером моделей и качеством ответов, но текущая реализация демонстрирует, что этот баланс достижим.