

Почему ИИ-судьи отвергают верные аргументы функций: эффект derivation gap
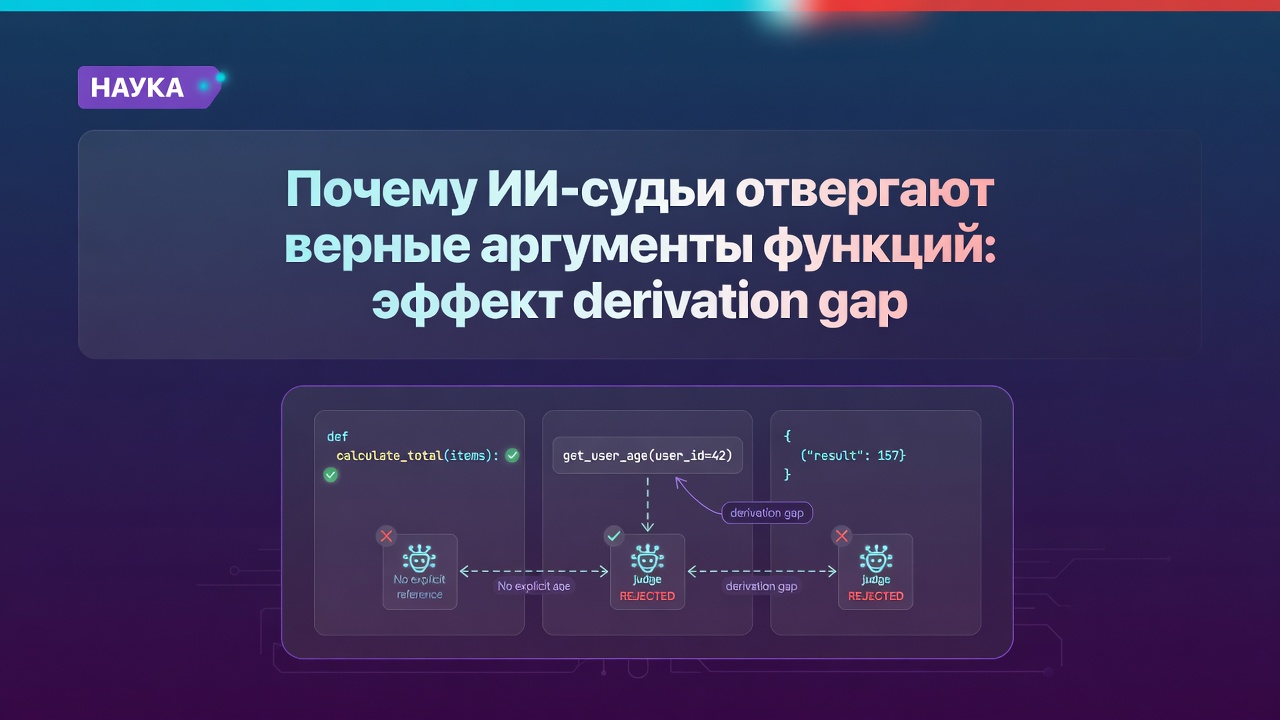
При оценке вызовов функций, которые генерируют языковые модели, специальные модели-судьи проверяют корректность передаваемых аргументов. Однако исследователи обнаружили, что судьи значительно реже принимают правильное значение, если в их входных данных нет прямой ссылки на него…
Главное
- Судьи реже принимают верные значения без явной ссылки в контексте
- Эффект проявляется у всех семи протестированных моделей-судей
- Разрыв вывода возникает при значениях по умолчанию, выводе и обрезке текста
- Проблема критична для агентных систем, где судьи фильтруют вызовы функций
При оценке вызовов функций, которые генерируют языковые модели, специальные модели-судьи проверяют корректность передаваемых аргументов. Однако исследователи обнаружили, что судьи значительно реже принимают правильное значение, если в их входных данных нет прямой ссылки на него — то есть текста, явно указывающего, каким должно быть значение.
Такая ситуация возникает в трёх случаях: когда значение является значением по умолчанию из схемы функции, которое пользователь явно не упоминал; когда значение требуется вывести из контекста; и когда текст, из которого это значение взято, был обрезан при формировании входных данных для судьи. Этот феномен получил название «разрыв вывода» (derivation gap).
Эффект проявляется у всех семи протестированных судей, что указывает на системную проблему, а не на ошибку конкретной модели. Это важно для разработчиков, использующих агентные системы на базе LLM: даже если модель генерирует верные аргументы, судья может их отклонить, что приведёт к ложным срабатываниям и снижению качества работы системы в целом.
Исследование подчёркивает необходимость улучшения методов оценки аргументов, возможно, путём включения в входные данные судьи дополнительных подсказок или явных ссылок на значения по умолчанию.