

Почему ИИ, обученный на контенте ИИ, деградирует: эффект AI Incest
Когда модели искусственного интеллекта обучаются на данных, которые сами были сгенерированы другими моделями, возникает явление, которое исследователи называют «AI Incest» (ИИ-инцест). Это процесс, при котором каждое новое поколение ИИ учится на результатах предыдущего, что…
Главное
- Модели ИИ деградируют при обучении на собственном контенте
- Синтетические данные усиливают ошибки и предубеждения
- Деградация заметна уже через несколько циклов обучения
- Решение — смешивание реальных и синтетических данных
- Необходимы методы фильтрации и коррекции ошибок
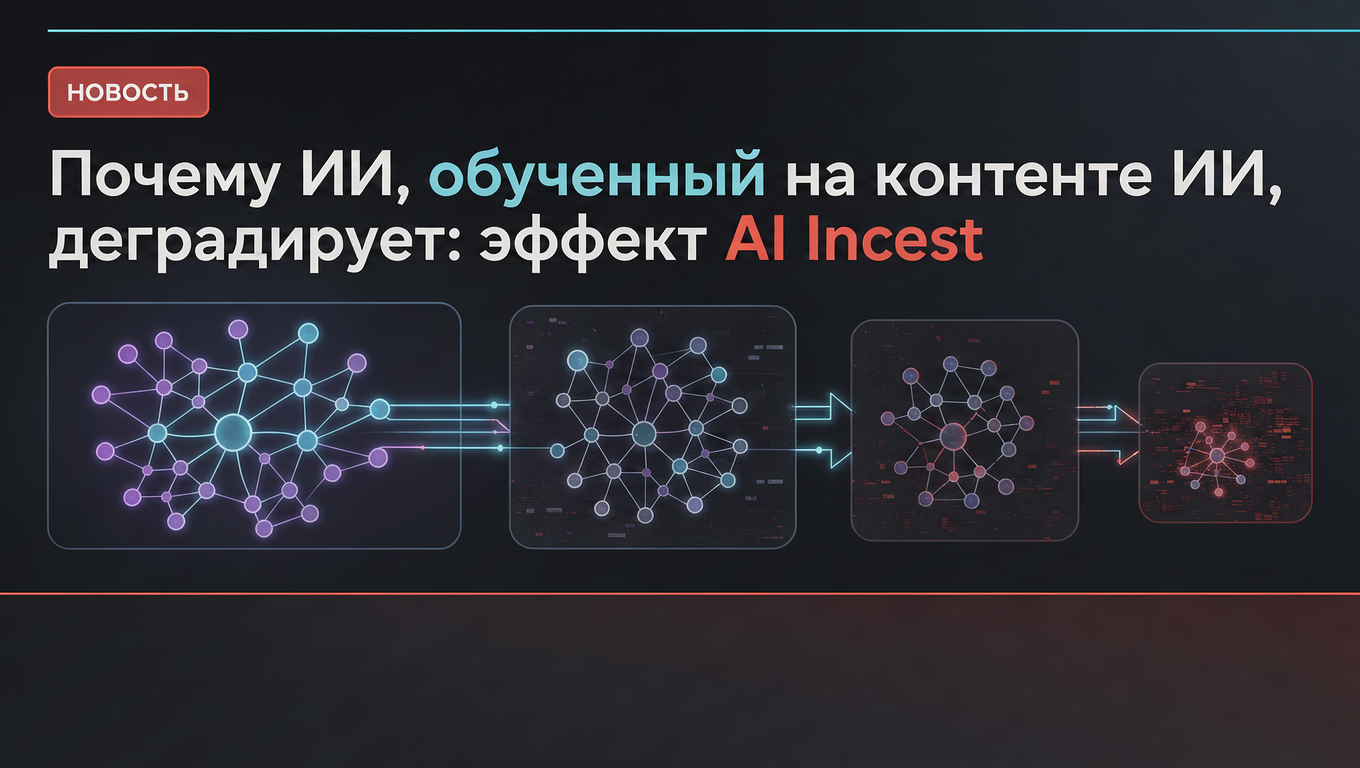
Когда модели искусственного интеллекта обучаются на данных, которые сами были сгенерированы другими моделями, возникает явление, которое исследователи называют «AI Incest» (ИИ-инцест). Это процесс, при котором каждое новое поколение ИИ учится на результатах предыдущего, что приводит к постепенной деградации качества и разнообразия выводов.
Суть проблемы в том, что модели, обученные на синтетических данных, теряют связь с реальным распределением информации. Они начинают усиливать ошибки и предубеждения, заложенные в предыдущих поколениях. Вместо того чтобы улучшаться, модели становятся менее точными, менее креативными и более склонными к повторению одних и тех же шаблонов. Это особенно критично для генеративных моделей, которые используются для создания текстов, изображений и кода.
Исследования показывают, что уже после нескольких циклов обучения на собственном выводе модели могут значительно деградировать. Например, в задачах генерации текста модель может начать выдавать бессвязные или однообразные фразы, а в задачах распознавания изображений — терять способность корректно классифицировать объекты. Это создает серьезные риски для индустрии, где синтетические данные все чаще используются для обучения новых моделей.
Однако проблема не является неразрешимой. Ученые предлагают несколько подходов: смешивать синтетические данные с реальными, использовать методы фильтрации для отсеивания низкокачественных примеров, а также разрабатывать алгоритмы, которые могут распознавать и корректировать системные ошибки. Важно понимать, что ИИ не может бесконечно самообучаться без притока свежих данных — это ограничение, которое необходимо учитывать при разработке будущих систем.