
Открытая модель CLM-8B от Stanford и Nvidia: кэширование действий ускоряет агентов до 9 раз
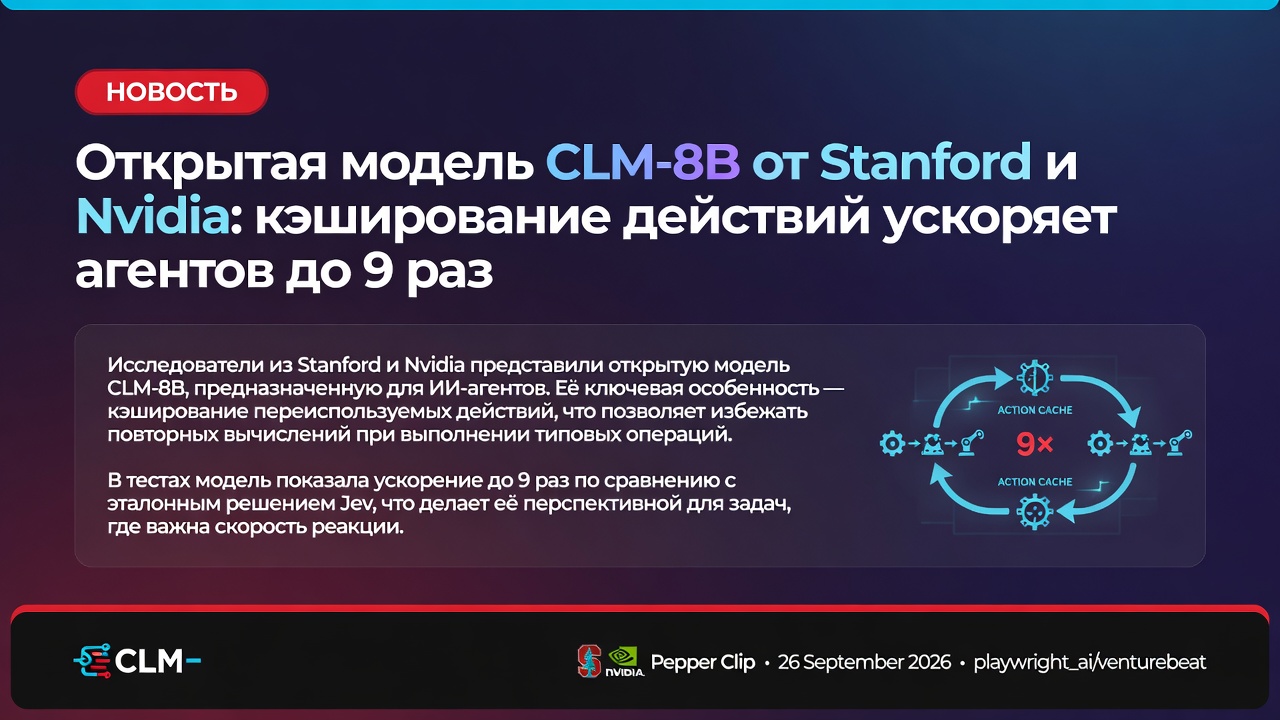
Исследователи из Stanford и Nvidia представили открытую модель CLM-8B, предназначенную для ИИ-агентов. Её ключевая особенность — кэширование переиспользуемых действий, что позволяет избежать повторных вычислений при выполнении типовых операций.
Главное
- CLM-8B — открытая модель для ИИ-агентов от Stanford и Nvidia
- Кэширование действий ускоряет выполнение до 9 раз по сравнению с Jev
- Модель сохраняет точность при сниженных вычислительных затратах
- Подходит для автоматизации задач с повторяющимися операциями
- Открытый код позволяет адаптацию и дообучение под свои сценарии
Исследователи из Stanford и Nvidia представили открытую модель CLM-8B, предназначенную для ИИ-агентов. Её ключевая особенность — кэширование переиспользуемых действий, что позволяет избежать повторных вычислений при выполнении типовых операций. В тестах модель показала ускорение до 9 раз по сравнению с эталонным решением Jev, что делает её перспективной для задач, где важна скорость реакции.
CLM-8B построена на архитектуре, оптимизированной для инференса в сценариях с повторяющимися шагами. Вместо того чтобы заново обрабатывать каждый вызов, модель сохраняет промежуточные результаты и использует их при последующих запросах. Это особенно полезно для агентов, работающих в средах с большим количеством однотипных операций, например, при автоматизации рабочих процессов или взаимодействии с инструментами.
Открытый характер модели означает, что разработчики могут адаптировать её под свои задачи, дообучать и интегрировать в собственные системы. При этом авторы подчёркивают, что ускорение достигается без потери качества решений — CLM-8B сохраняет точность на уровне более тяжёлых моделей, но требует меньше вычислительных ресурсов за счёт кэширования.
Практическая значимость разработки в том, что она снижает порог внедрения ИИ-агентов в реальные продукты: уменьшается задержка ответа и нагрузка на инфраструктуру. Для исследователей это шаг к более эффективным архитектурам, где повторное использование вычислений становится стандартным приёмом.