

Как дашборды инференса LLM помогают оценивать производительность моделей
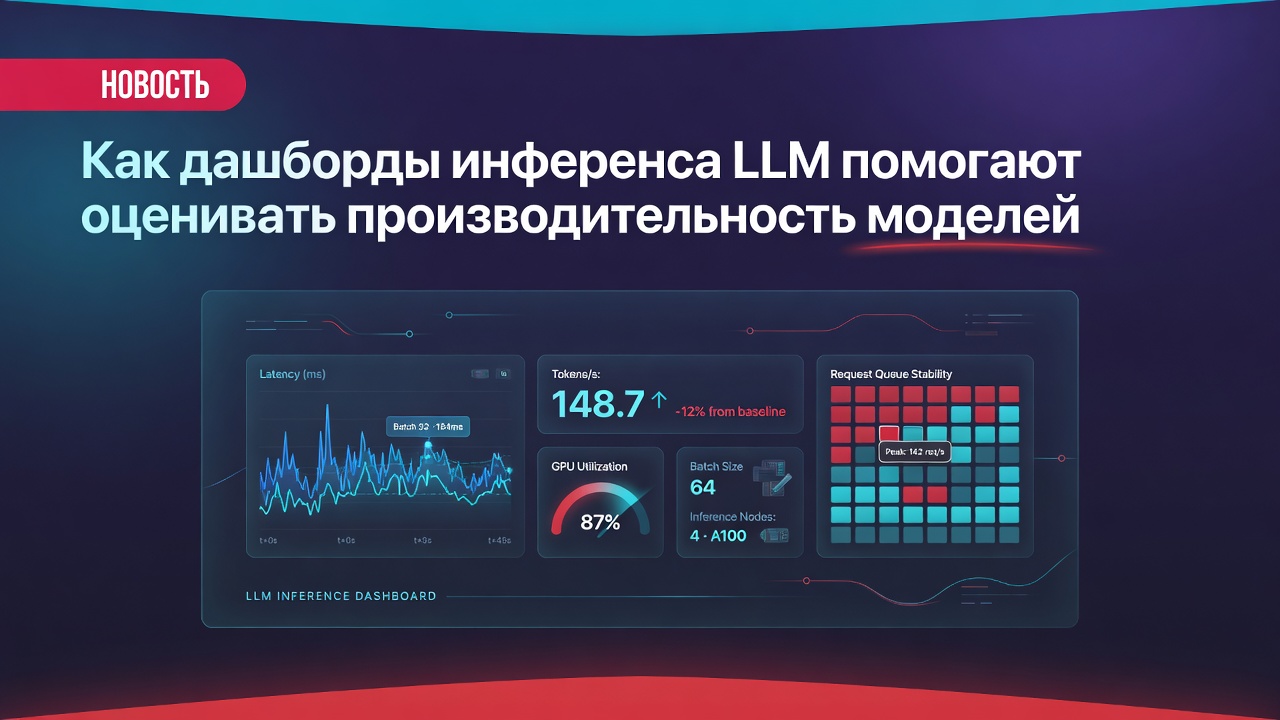
LLM Inference Dashboard — это инструмент для наблюдения за работой больших языковых моделей на этапе инференса. Инференс — это процесс получения ответа моделью после того, как она обучена.
Главное
- Инференс — этап получения ответа обученной моделью, его скорость влияет на пользовательский опыт
- TTFT и токены в секунду — базовые метрики для оценки скорости работы LLM
- Дашборд помогает выявить узкие места: очередь запросов, загрузку GPU и ошибки
- Сравнение конфигураций по метрикам позволяет оптимизировать развёртывание без лишних затрат
LLM Inference Dashboard — это инструмент для наблюдения за работой больших языковых моделей на этапе инференса. Инференс — это процесс получения ответа моделью после того, как она обучена. На практике скорость и стабильность ответов зависят от множества параметров: от типа аппаратного обеспечения до размера пакета запросов. Дашборд собирает эти параметры в единое окно и позволяет инженерам видеть, где именно возникают задержки.
Ключевые метрики обычно включают время до первого токена (TTFT), скорость генерации токенов, задержку полного ответа и количество запросов в очереди. TTFT показывает, как быстро модель начинает отвечать после получения запроса. Скорость генерации токенов измеряется в токенах в секунду — токенами модели называют фрагменты текста, из которых складываются слова. Вместе эти показатели дают понять, насколько комфортным будет взаимодействие для пользователя.
Такой дашборд полезен при сравнении моделей и конфигураций. Например, можно увидеть, что одна модель быстрее генерирует токены, но дольше обрабатывает длинные промпты. Или что увеличение числа параллельных запросов снижает задержку до определённого предела, а затем ведёт к росту очереди. Анализ этих данных помогает выбирать оптимальные настройки развёртывания без слепого увеличения мощностей.